[ FIELD ]
Operator Check : lequel de ces six modèles renverriez-vous ?
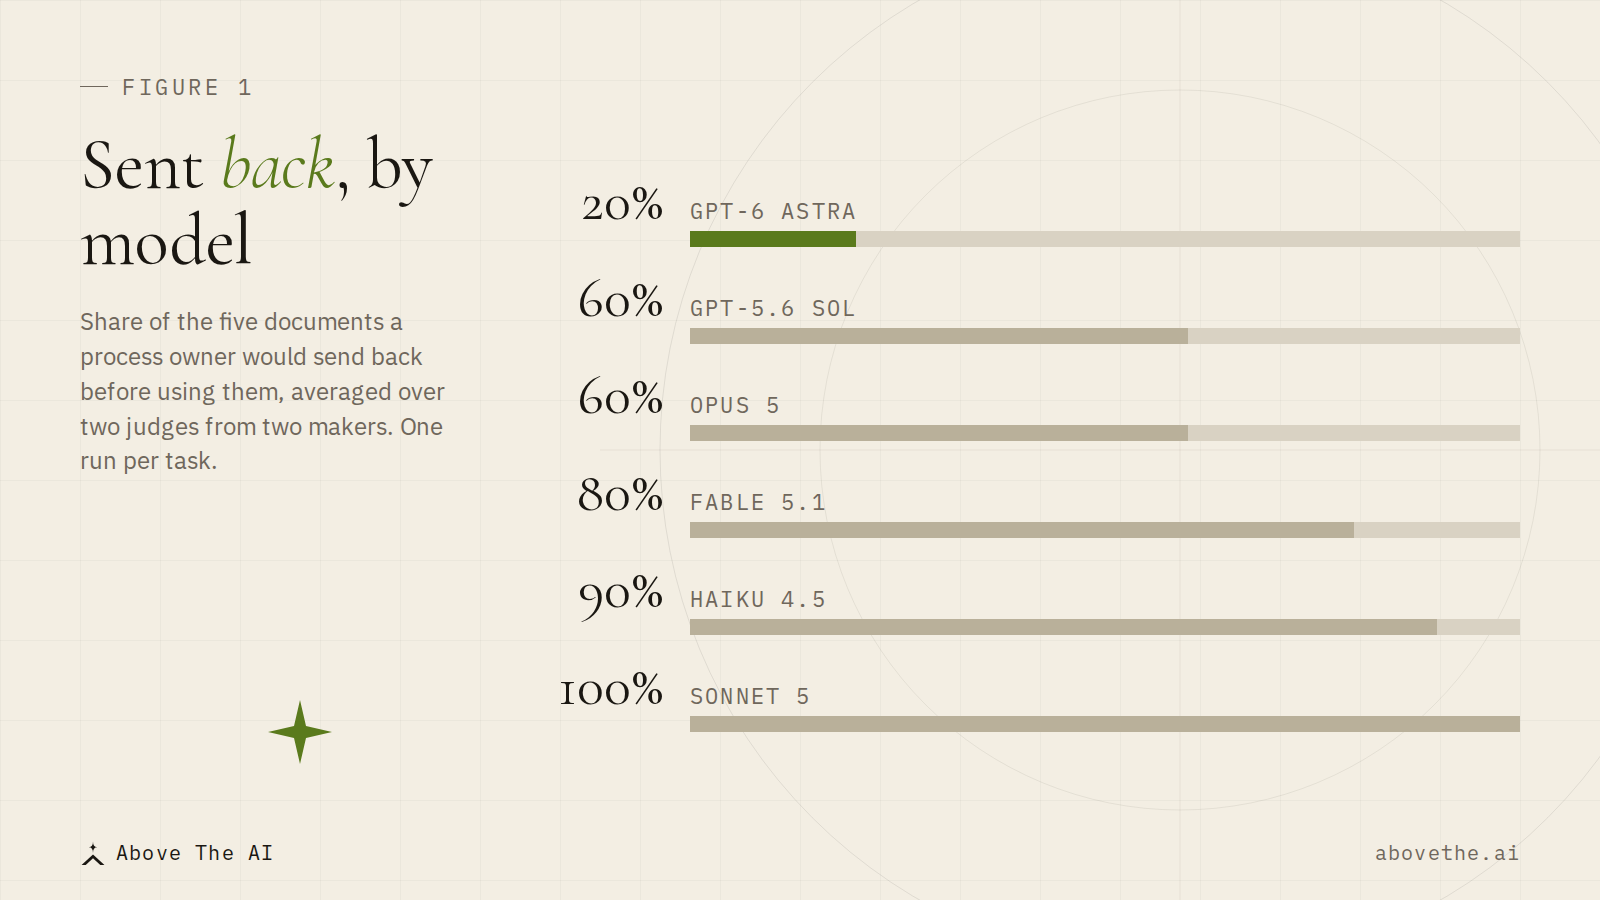
Nous avons donné à GPT-6 Astra, GPT-5.6 Sol, Claude Fable 5.1, Opus 5, Sonnet 5 et Haiku 4.5 les mêmes cinq documents qu'une entreprise de taille moyenne écrit chaque semaine, un mémo de crédit, un commentaire des écarts, un appel d'offres, une réponse à réclamation, un compte rendu de réunion, et posé à deux juges de deux éditeurs une seule question : la personne responsable de ce processus le renverrait-elle. Astra : une fois. Sonnet 5 : cinq fois. La faute qui fait perdre est l'invention, pas l'arithmétique.
2026-09-04 · 11 min de lecture
Nous avons donné à six modèles d'IA les mêmes cinq documents à rédiger, ceux qu'une entreprise de taille moyenne produit chaque semaine, et nous avons posé à deux juges, qui ne savaient pas quel modèle avait écrit quoi, une seule question sur chacun : la personne qui est responsable de ce processus le renverrait-elle avant de s'en servir. GPT-6 Astra, sorti le 3 septembre, a été renvoyé une fois sur cinq. Claude Sonnet 5, cinq fois sur cinq. La différence tenait rarement à l'arithmétique. Elle tenait à l'invention : les modèles qui ont perdu ont ajouté des choses qui n'étaient pas dans les données, une cause pour une baisse des ventes, une procédure que l'entreprise n'a pas, une date que personne n'avait donnée, et une personne aurait dû trouver et retirer chacune d'elles.
C'est le premier Operator Check. Chaque sortie de modèle est évaluée en quelques jours par des gens qui écrivent du code et des essais. Personne ne les évalue sur le travail qu'un directeur des opérations, un responsable financier ou un responsable d'appels d'offres remet réellement. Nous avons donc construit le test nous-mêmes, et nous le ferons tourner à chaque sortie, mêmes cinq tâches, même règle.
Le dispositif
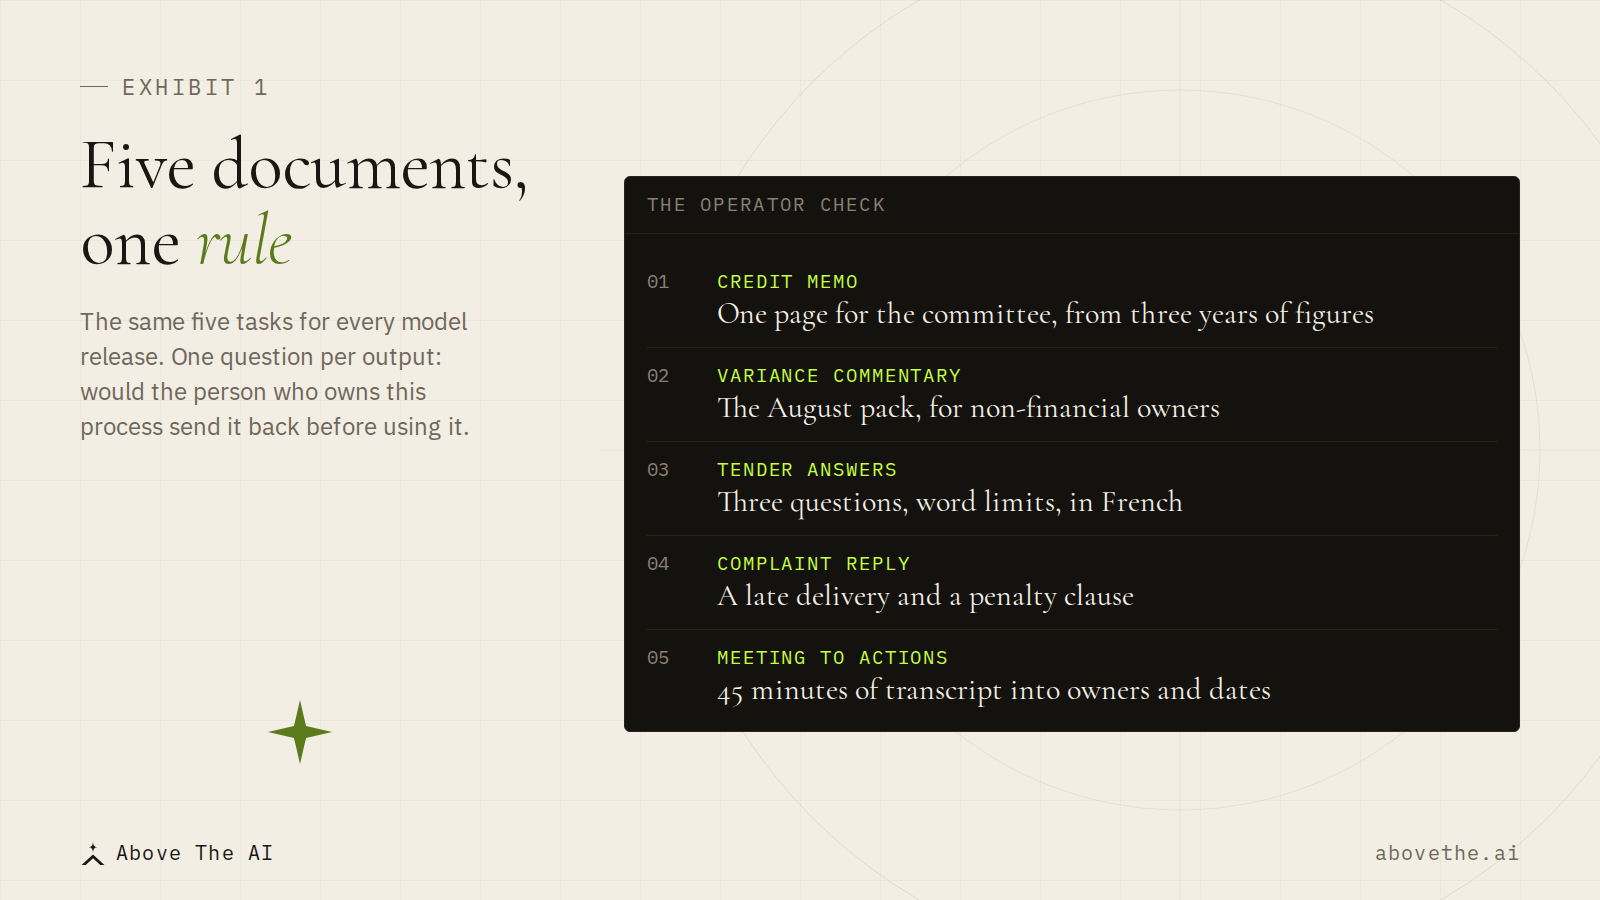
Cinq tâches, chacune un vrai document avec une limite de mots et une règle sur ce qu'il ne faut pas inventer. Un mémo de crédit d'une page pour un comité bancaire, à partir de trois années de chiffres d'un industriel. Le commentaire des écarts d'août du reporting mensuel d'un distributeur, pour un conseil d'actionnaires non financiers. Trois réponses à un appel d'offres public, en français, à partir du profil d'une société de services. Une réponse à un client qui se plaint d'une livraison en retard, avec une clause de pénalités à appliquer à la lettre. Une réunion d'exploitation de 45 minutes transformée en décisions, responsables et dates.
Chaque donnée d'entrée est inventée, écrite pour ce test afin qu'aucun client n'y figure, et cohérente avec elle-même : le compte rendu de réunion et le reporting décrivent la même entreprise le même mois. Les données sont dans le dossier en fin d'article, pour que vous puissiez faire passer les mêmes cinq tâches à ce que vous envisagez d'acheter.
Six modèles : les deux plus récents d'OpenAI, GPT-6 Astra et GPT-5.6 Sol, et les quatre actuels d'Anthropic, Claude Fable 5.1, Opus 5, Sonnet 5 et Haiku 4.5, du plus gros au moins cher. Chacun est passé par l'outil que son éditeur livre exactement pour ce genre de délégation, Codex et Claude Code. Un passage par tâche, pas de seconde chance, outils désactivés, la tâche collée avec une seule consigne : répondre sous la forme du document fini.
Deux juges ont lu chaque résultat sans savoir quel modèle l'avait écrit : Claude Opus 5 et GPT-6 Astra, un de chaque éditeur, avec en main les données, le résultat et une grille de correction que nous avons écrite à la main (le calcul du ratio d'endettement, le montant de la pénalité, les décisions réellement prises en réunion). Chaque juge a répondu à la question unique, puis listé chaque erreur de fait, chaque fait inventé et chaque consigne enfreinte. Soixante jugements en tout. Là où les deux juges divergent, nous le disons.
La règle compte plus que les notes, et c'est celle que vous appliquez déjà à un junior. Un document qu'une personne doit corriger sur un point avant qu'il compte est un document qui a besoin d'une personne. Le taux de renvoi, la fréquence à laquelle l'humain le renvoie, est le chiffre qui dit si un agent fait le travail ou tourne seulement, et c'est le chiffre qu'aucun fournisseur ne publie.
Tâche un : le mémo de crédit
Les données cachent un calcul. L'endettement de l'emprunteur, dette nette divisée par le résultat d'exploitation, est de 1,6 fois fin 2025. Ajoutez les 6 millions de prêt demandés et il passe à environ 3,3 fois, au-dessus de la limite de 3,0 fois déjà écrite dans ses contrats de prêt, ce que les banquiers appellent un covenant. Un mémo qui ne le voit pas est un mémo que le comité renvoie.
Quatre sur six l'ont vu. GPT-6 Astra a écrit qu'ajouter le prêt « implique un levier de 3,25x à EBITDA inchangé » et a recommandé de garder la limite de 3,0 et de ne pas y renoncer « sur la seule base de la croissance aéronautique attendue ». Les deux juges l'ont validé ; le juge OpenAI l'a jugé utilisable tel quel, le juge Anthropic voulait une phrase de plus pour nommer le dépassement noir sur blanc. Fable 5.1 et Opus 5 ont tous deux trouvé le chiffre et ont partagé les juges : validés par le juge Anthropic, renvoyés par le juge OpenAI pour des réconforts sans fondement (« les causes de la faiblesse de 2025 sont largement non récurrentes », « un client de longue date », rien de cela dans les données).
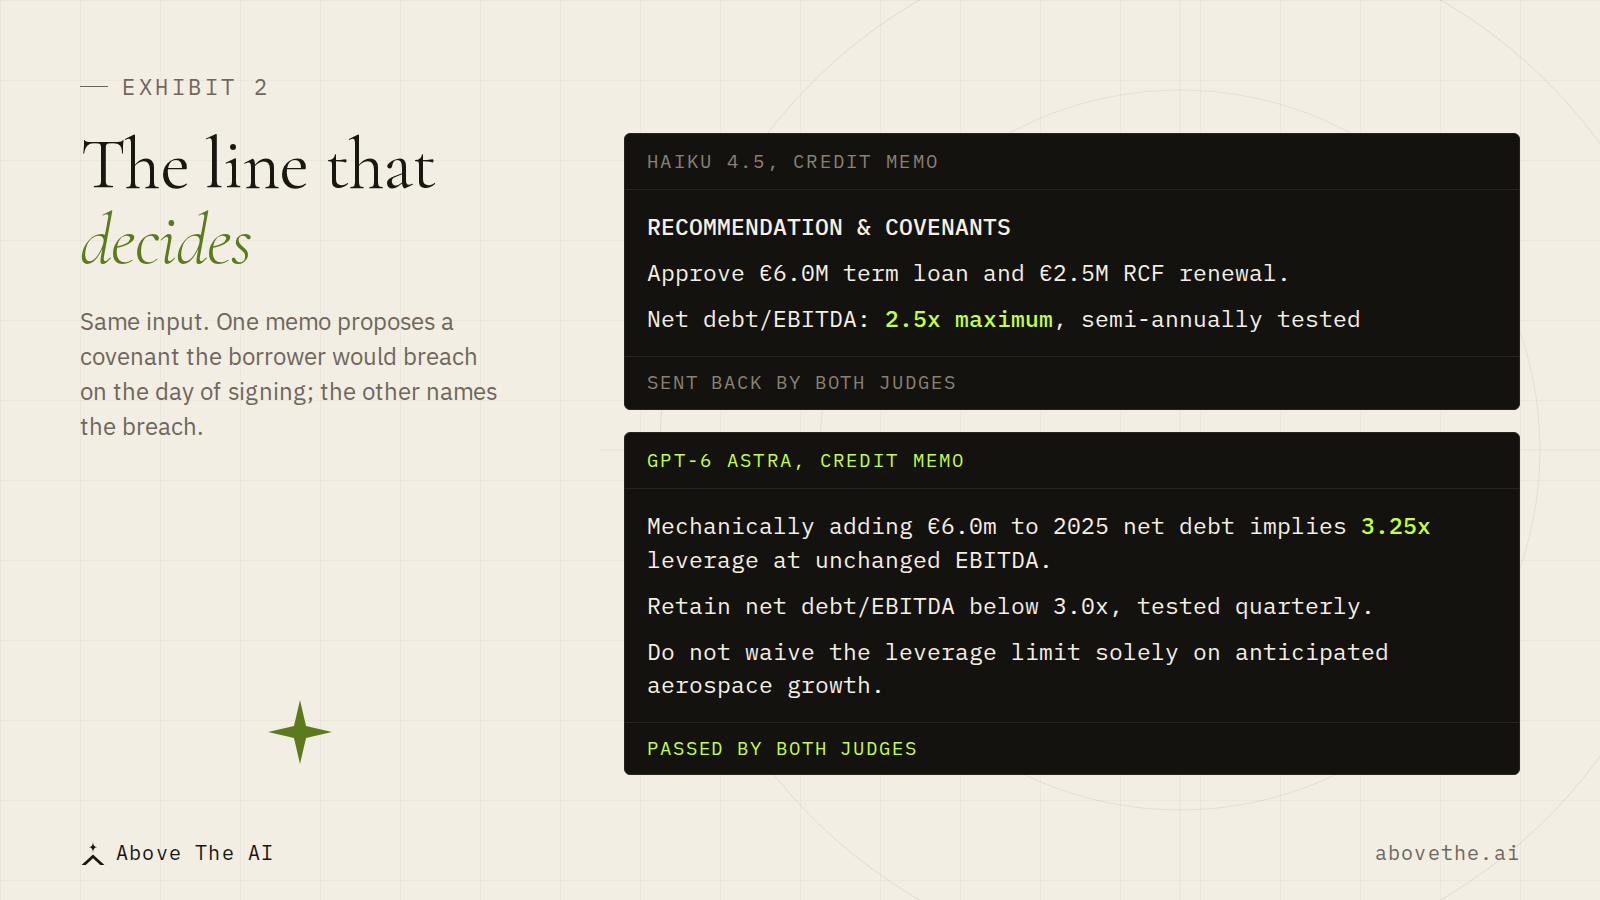
Sonnet 5 a écrit que l'endettement après le prêt ne pouvait pas être calculé, puis a proposé d'approuver. Haiku 4.5 ne l'a jamais calculé et a proposé un nouveau covenant à 2,5 fois, que l'emprunteur enfreindrait le jour de la signature. Les deux juges ont renvoyé les deux, et leurs motifs étaient la même phrase avec d'autres mots : le mémo rate la seule chose dont le comité a besoin.
Tâche deux : le commentaire des écarts
Le reporting donne un mois, un cumul depuis janvier, et trois notes : une promotion, deux intérimaires ajoutés en juillet, un gros client qui a avancé ses commandes de septembre à juillet. La consigne : signaler chaque ligne qui a bougé, et ne pas inventer de causes.
C'est le partage le plus net des cinq. Les deux modèles GPT ont été validés par les deux juges, jugés utilisables tels quels. Chaque modèle Claude a été renvoyé par les deux juges, pour la même faute : des causes que le reporting ne contient pas. Fable 5.1 a écrit qu'« août est le pire mois » (le reporting n'a pas d'autres mois) et que les impayés « ont presque doublé » (310 à 520, c'est 68 %). Sonnet 5 a proposé des « camions partiellement chargés du fait de volumes plus faibles » pour expliquer le dépassement transport. Haiku 4.5 a lu la note sur les commandes de septembre avancées à juillet comme l'explication d'août, ce qu'elle ne peut pas être. Opus 5, le plus discipliné des quatre, s'est trompé de 9 milliers dans la réconciliation de l'écart de résultat, et les deux juges l'ont vu.
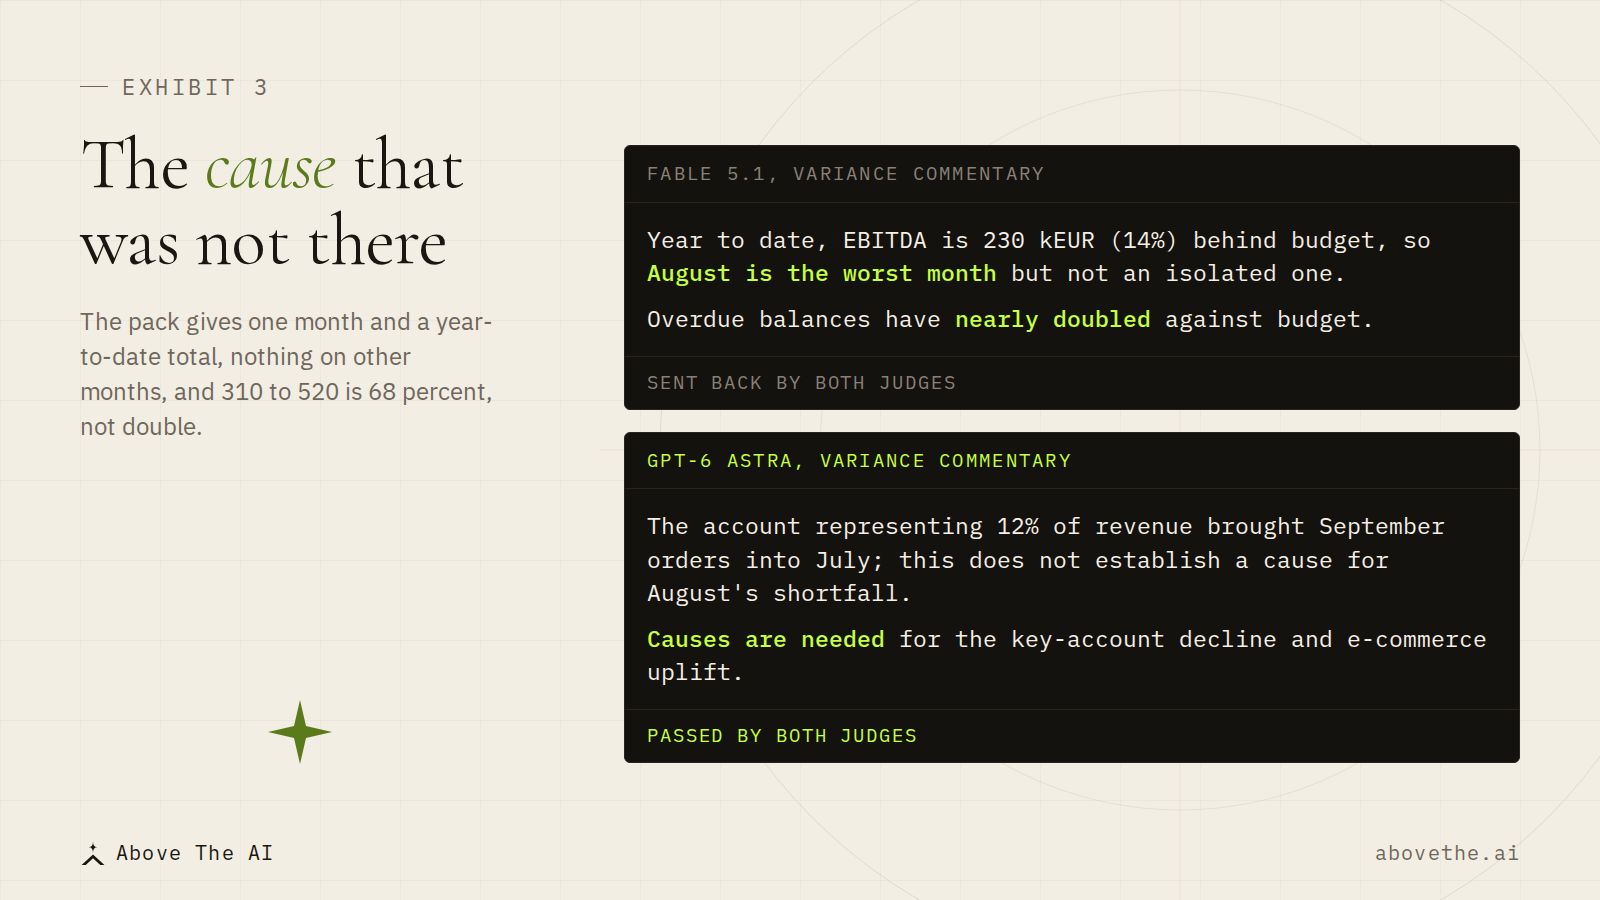
La version d'Astra dit qu'une cause est nécessaire, en ces mots ou presque, six fois. Ce n'est pas une faiblesse. C'est le commentaire sur lequel un conseil peut agir, parce que chaque trou est une question avec un nom.
Tâche trois : l'appel d'offres
Un appel d'offres est la mise en concurrence écrite d'un acheteur public pour un contrat. Trois réponses en français, à partir d'un profil d'entreprise qui donne des chiffres (94 agents, 6,1 % d'absentéisme, 71 % de produits écolabellisés) mais aucun délai de remplacement et aucune procédure de contrôle qualité. Le piège : l'acheteur public demande les deux, et un responsable d'offres qui les invente engage l'entreprise sur quelque chose qu'elle n'a pas.
Personne n'est passé proprement. Astra a refusé d'inventer et a été renvoyé par les deux juges pour la raison inverse : le juge Anthropic a écrit que le texte lit comme une note d'audit qui refuse de répondre au lieu d'une offre. Les quatre modèles Claude ont répondu aux questions de l'acheteur et ont été renvoyés pour ce qu'ils ont ajouté : une procédure de réaffectation sous 24 heures, une application qui déclenche un remplacement sur absence de pointage, une revue mensuelle des plannings, un lien entre temps partiel et turnover. Opus 5 en a ajouté le plus selon le décompte du juge OpenAI, Haiku et Sonnet selon celui du juge Anthropic ; le juge OpenAI a jugé la version de Fable impropre à une soumission en l'état. Opus 5 est la seule décision partagée, validé avec réserves par le juge Anthropic, renvoyé par le juge OpenAI.
Lisez cette tâche comme la plus honnête. Une réponse à appel d'offres est l'endroit où l'opérateur veut que le modèle soit sûr de lui, et la confiance ici, c'est de la fabrication. La version utilisable, c'est le refus plus une personne, et cela vaut la peine de le savoir avant qu'une offre parte avec un niveau de service que personne n'a accepté.
Tâche quatre : la réclamation
Un client veut le remboursement des pénalités par virement sous huit jours et 6 000 euros pour une journée de production perdue. Le contrat dit 0,5 % par jour ouvré, plafonné à 5 %, crédité sur la prochaine facture. La bonne réponse : 1 344 euros, en avoir, et non.
Les six ont fait le bon calcul. Les six ont refusé le virement et les 6 000. Les différences tenaient au ton et à la longueur : Sonnet 5 a fait 255 mots pour une limite de 220 et a été renvoyé par les deux juges ; le juge OpenAI en a renvoyé cinq sur six, pour un espace vide à la place du nom de l'entreprise, une affirmation sur ce que le contrat exclut que le contrat ne dit pas, ou une mesure corrective sans date. Le juge Anthropic en a validé cinq. Si votre cas d'usage est la correspondance client sous contrat, tous les modèles ici sont proches, et la relecture porte sur les mots, pas sur les faits.
Tâche cinq : la réunion
Le compte rendu contient une décision (les intérimaires de juillet s'arrêtent le 30 septembre, Mehdi en est responsable) et, dix minutes plus tard, deux personnes qui proposent l'inverse, à quoi la directrice des opérations répond « on verra ». Il contient aussi des dates qui ne sont que « vendredi » et « demain », et aucun responsable pour plusieurs actions. La consigne : ne pas inventer de responsables ni de dates.
Les six ont repéré la contradiction. Ce qui les a séparés, ce sont les responsables et les dates. Fable 5.1 a confié à Mehdi la confirmation du démarrage de l'agence d'intérim, que la directrice avait gardée pour elle. Haiku 4.5 a écrit « 8 septembre » pour un rapport que le compte rendu date seulement de « vendredi ». Sonnet 5 a écrit « 11 septembre » pour le même rapport, et nous devons ici une correction au modèle : notre compte rendu dit « lundi 8 » et le 8 septembre 2026 est un mardi, donc le calendrier des données est faux, et les deux juges ont sanctionné des déductions de dates avec une grille qui ne valait pas mieux que les suppositions. Astra, Sol et Opus 5 ont été validés par le juge Anthropic ; le juge OpenAI n'a validé qu'Astra et a renvoyé les autres pour des détails, un responsable, une condition aplatie, une décision listée qui n'avait pas été prise. Lisez les verdicts de cette tâche comme fragiles.
Le verdict
GPT-6 Astra, un sur cinq renvoyé par les deux juges. Il a fait les calculs, il a nommé le dépassement de covenant, et là où les données se taisaient il l'a dit au lieu de combler le trou. Son seul échec est l'appel d'offres, où le dire n'est pas une réponse. Si vous confiez à un modèle un document qui doit être juste et ne doit pas dépasser son mandat, c'est celui-là.
GPT-5.6 Sol, deux sur cinq selon le juge Anthropic, quatre sur cinq selon le juge OpenAI. Bien sur le reporting, renvoyé sur le mémo et l'appel d'offres par les deux juges, et par le modèle de son propre éditeur sur la réclamation, pour un nom d'entreprise laissé vide, et sur le compte rendu, pour un effectif que le compte rendu ne donne pas.
Claude Opus 5, un sur cinq selon le juge Anthropic, cinq sur cinq selon le juge OpenAI, le plus grand désaccord des six. Soigneux sur le mémo, faux sur la réconciliation du reporting, et enclin à ajouter de la procédure à l'appel d'offres. Le juge OpenAI a compté 22 faits inventés sur ses cinq documents.
Claude Fable 5.1, trois et cinq. Le rédacteur le plus fluide ici et celui qui dépasse le plus ses limites de mots, trois fois sur cinq, et le plus enclin à ajouter : 19 et 20 faits inventés selon les deux juges. Il a trouvé le covenant. Il a aussi inventé la date du comité.
Claude Haiku 4.5, quatre et cinq. Peu cher et rapide, et il a raté le calcul qui décide du mémo de crédit, puis proposé un covenant que l'emprunteur enfreindrait à la signature.
Claude Sonnet 5, cinq et cinq. Renvoyé sur chaque tâche par les deux juges. Il a esquivé le ratio d'endettement, dépassé la limite sur deux tâches, deviné des causes dans le reporting et ajouté une devise que le compte rendu ne donnait pas.
Prenez Astra si le document contient une bonne réponse cachée et qu'une personne le lira une fois. Gardez Opus 5 ou Fable 5.1 pour des brouillons qu'une personne réécrira de toute façon, là où la fluidité fait gagner du temps et où la relecture est déjà dans le processus. Ne mettez pas Sonnet 5 ou Haiku 4.5 devant un comité, un conseil ou un acheteur public sans quelqu'un qui connaît les données et lit chaque ligne.
Temps et coût
Sonnet 5 a été le plus rapide, 17 secondes par document en moyenne ; Fable 5.1 le plus lent à 40, l'appel d'offres prenant 80. Les modèles GPT étaient à 29 et 32 secondes. Le coût n'est pas comparable entre les deux outils : Claude Code donne un prix, de 7 centimes pour les cinq documents de Haiku à 94 centimes pour ceux de Fable ; Codex ne donne que des tokens, l'unité dans laquelle les éditeurs facturent, environ 19 000 pour les cinq documents d'Astra contre 65 000 à 85 000 pour les modèles Claude, et les outils n'ont pas les mêmes frais fixes par appel. Lisez les rapports, pas les chiffres. Sur n'importe lequel, le modèle coûte des centimes par document. La personne qui le lit, non.
Ce que ce test ne dit pas
Un passage par tâche. Les modèles varient d'un passage à l'autre, et un second passage déplacerait certains de ces verdicts ; la prochaine sortie aura droit à cinq passages. Les données sont inventées, construites pour être ordinaires et cohérentes, et un modèle peut se comporter autrement sur vos documents plus désordonnés. Les juges sont des modèles, un par éditeur, et ils n'ont pas été d'accord partout : le juge OpenAI a été plus dur avec les modèles Claude que le juge Anthropic avec qui que ce soit, et les deux ont jugé Astra avec bienveillance. C'est pourquoi les deux sont rapportés. Les outils sont les produits en ligne de commande des éditeurs, avec leurs propres consignes autour du modèle, pas le modèle brut. Notre compte rendu de réunion portait une erreur de calendrier, un lundi qui était un mardi, ce qui fragilise chaque verdict sur les dates de la tâche cinq ; les données du prochain test seront vérifiées contre un calendrier avant d'être vérifiées contre un modèle. Et cet article a été rédigé avec Fable 5.1, arrivé quatrième.
Le kit
Vous n'avez pas besoin de nos scripts pour faire passer ce test à l'outil que vous vous apprêtez à acheter. Le kit, ce sont treize fichiers texte et une procédure de dix minutes par tâche, dans deux fenêtres de chat. Collez l'un des cinq fichiers de tâche dans l'outil que vous évaluez et prenez sa réponse telle quelle. Ouvrez un second chat, de préférence avec un modèle d'un autre éditeur, collez la consigne du juge, la tâche, la réponse et la grille de correction correspondante, et lisez le verdict. Notez-le sur la feuille de score : renvoyé ou non, utilisable de 0 à 3, erreurs, faits inventés. Cinq tâches, six lignes, et vous avez la comparaison qu'un fournisseur ne vous donnera pas, sur le même travail, avec la même règle.
Une fois ces cinq tâches passées, remplacez-les par cinq de vos propres documents. La règle ne change pas ; les données, si.
Le prochain test tourne à la prochaine sortie.